Data products
Madrid NO₂ Forecasting
Previsión de NO₂ por estación en Madrid a 1, 24 y 72 horas, sin fugas de información.
- Año
- 2026
- Rol
- Data & ML Engineer
El problema
La mayoría de portfolios de forecasting inflan sus resultados filtrando información del futuro en las features o evaluando con splits aleatorios. Yo quería lo contrario: una evaluación de series temporales honesta y reproducible sobre los datos oficiales de calidad del aire de Madrid, donde cada afirmación corresponde a una comprobación ejecutable.
Qué construí
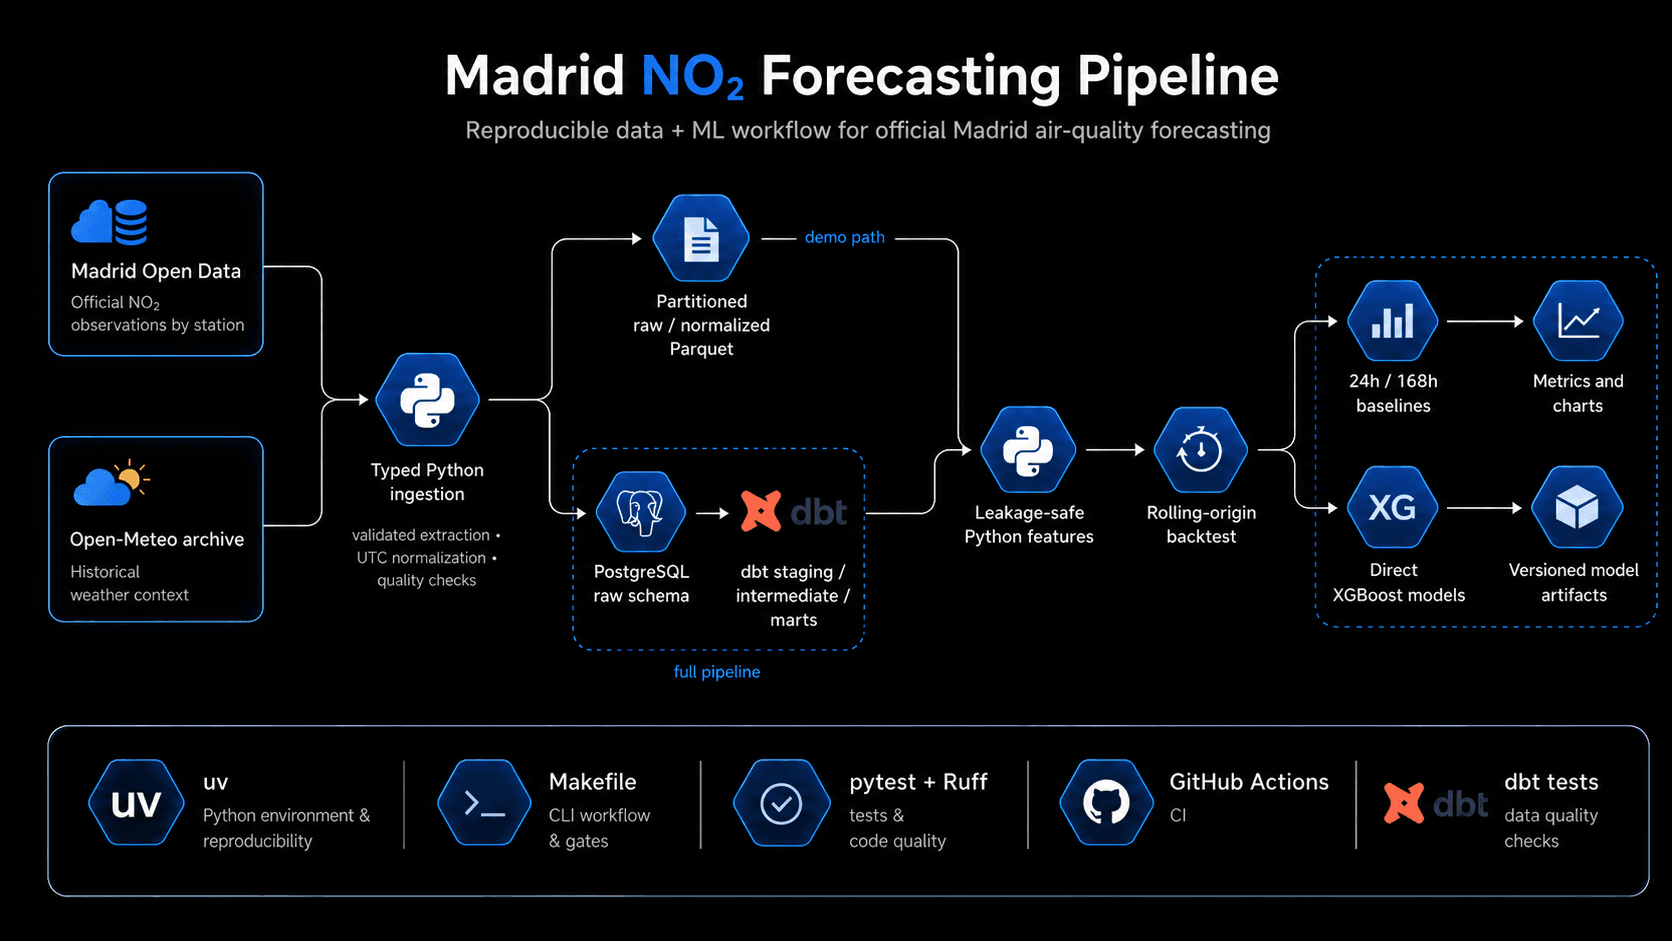
Un pipeline de principio a fin: ingesta tipada en Python de Madrid Open Data (más de 1,6 millones de observaciones horarias, de 2018 a 2025), marts en PostgreSQL modelados con dbt, feature engineering sin fugas, backtesting rolling-origin con embargo temporal y un modelo XGBoost directo por horizonte con intervalos conformales P10 a P90.
- 01Madrid Open Data
- 02Python Ingestion
- 03PostgreSQL
- 04dbt
- 05Leakage-safe Features
- 06XGBoost
- 07Rolling-origin Backtest
Cómo está hecho
- La ingesta tipada en Python normaliza los datos oficiales de Madrid y los archivos de Open-Meteo en Parquet particionado y un esquema raw en PostgreSQL, con normalización a UTC y gestión explícita del cambio de hora.
- dbt se encarga del grano analítico y la calidad del dato en las capas staging, intermediate y mart. Python se encarga de features, backtesting, entrenamiento y predicción.
- Las features se limitan al momento de la predicción (solo lags y estadísticas móviles desplazadas), y hay tests de pytest que fallan si entra información del futuro.
- Los backtests rolling-origin comparan XGBoost por horizonte contra baselines estacionales ingenuos, con manifiestos de benchmark versionados que protegen las métricas publicadas.
Resultados
- Un 50% menos de MAE que el mejor baseline ingenuo a 1 hora, y mejoras honestas y modestas de ~12% a 24 y 72 horas.
- Un clon limpio reproduce la demo con un solo comando, y la CI ejecuta la integración real con PostgreSQL y dbt en cada push.
- Las previsiones incluyen intervalos conformales empíricos, reportados por su peor fold y no por la media.
Siguientes pasos
Añadir features de previsiones meteorológicas archivadas (que sí se conocían en el momento de predecir) y calibración conformal adaptativa para corregir la infracobertura en los folds de cambio de estación.
Stack
- Python
- PostgreSQL
- dbt
- XGBoost
- pytest
- uv
- Docker
- GitHub Actions
Siguiente proyecto
Chicago Taxi Trips vs Weather